 一声喵
判为自建类
结果卡换成你起的名字,盖过内置 11 类的结论,右上角标一个「自建」。
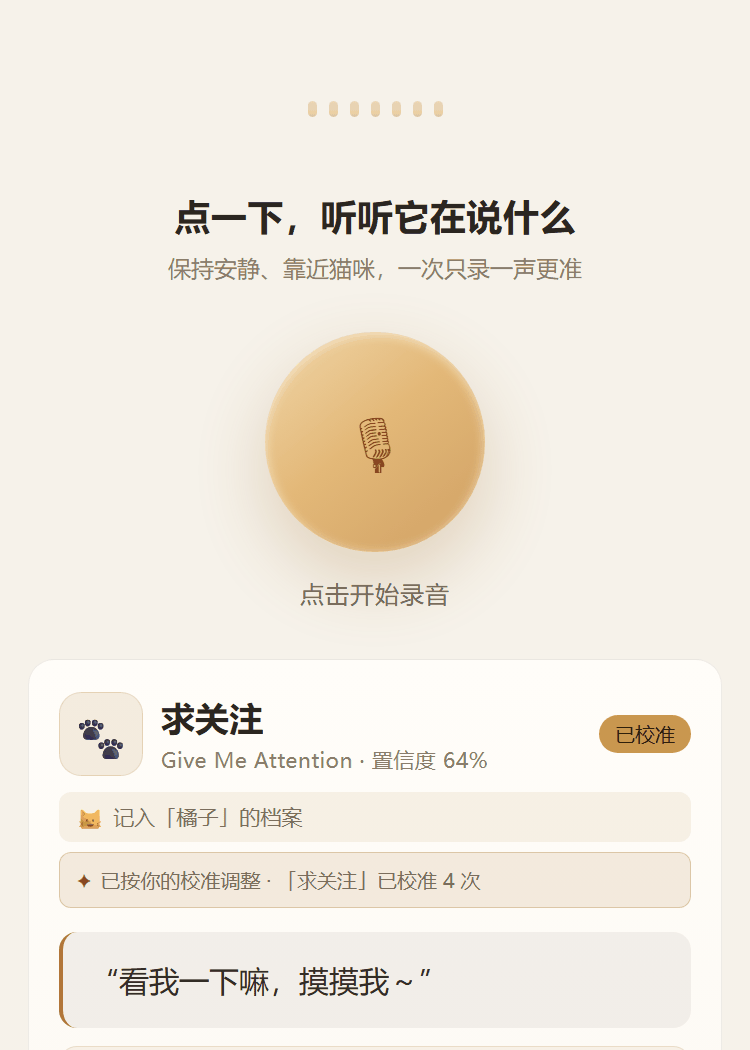
一声喵是一款微信小程序。录下一段猫咪的叫声,它在手机本地分析声音的基频、时长、音节、能量等 20 项声学特征,用一套加权规则判断这声喵更可能属于哪一类心理状态,共 11 类。11 类之外,还能给自家猫特有的叫法自己起个名字。整个过程不需要联网,录音不会上传。
判断结果落在这 11 类里。它们是心理状态层面的粗分类,不是逐字翻译。都不像的话,可以自己起一个。
窝在你身边、被摸下巴时的短促轻哼
你刚进门、或者它在空碗旁边对着你叫
低沉的持续音,通常在你不该再靠近的时候
退到角落、耳朵后压时的戒备声
被抱起又挣不脱、或被打扰睡眠
嘶声、哈气,配合前扑姿态
母猫招呼幼猫时的低频呼唤
发情期长而重复的叫声
尖锐、突然、不常规的哀叫
困倦时的短叹式气声
盯着窗外鸟时那种压低的咔咔声
有些叫法就是落不进那 11 个格子。给它起一个你自己的名字,录几条样本,之后这一类按声音的相似度来认。
在小程序首页的「我的喵意」区块点「+ 新建」,给这种叫法起个名字、挑个表情,再录 3 条以上样本。不用改代码,不用联网,建完当场生效。
判定不靠你写的名字,靠声音本身。每条样本会被压成 12 个形态量——基频高低、音调起伏、音节数、段间隔、过零率、抖动这些,每一项都与音量大小、录音长短无关。系统用它们的中心点和离散程度算出一个半径,新的叫声落在半径以内够近的位置,才认成这一类。
和内置结果冲突时,自建优先。这是你亲手标过的,比通用规则更该被相信。反过来,样本不到 3 条时它不参与判断,免得一条随手录的杂音把整类带偏。
边界也说清楚:自建类只认你录过的那种叫法。猫换个调子、换个场景,它可能就认不出来,这时候补录一条比反复试更有用。
示意而已。你的列表在小程序里,随时能补录、改名、删除。
结果卡换成你起的名字,盖过内置 11 类的结论,右上角标一个「自建」。
结果卡下方加一行虚线提示「可能是……」,原来的判断照旧显示,决定权还在你手里。
当作不在这一类的范围里,不打扰你,也不为了凑数硬套一个自己起的名字。
两个门槛不是随手定的:类型半径取样本两两距离的中位数再放宽一档,样本越集中,门槛就越严;明显离群的样本会被拦下,不参与算中心点。自建类型只保存特征向量,不保存音频。删掉某个类别后,历史记录里已经生成的结论保留原文,之后的判断不再使用它。
三步,全部在手机上完成。没有云端模型,也没有把录音发出去做推理。
把录音解析成 PCM 波形,按 512 个采样点一帧、256 步长切分,加窗归一化,为逐帧分析做准备。
用归一化自相关求每帧基频,再统计基频均值与范围、音节数、时长、能量包络与峰值因数、过零率、抖动、基频起落幅度与走向等共 20 项标量。
11 类各有一组声学规则,命中即累加得分,经 softmax 归一成概率,输出一个 42% 至 95% 的置信度,以及触发本次判断的具体依据。
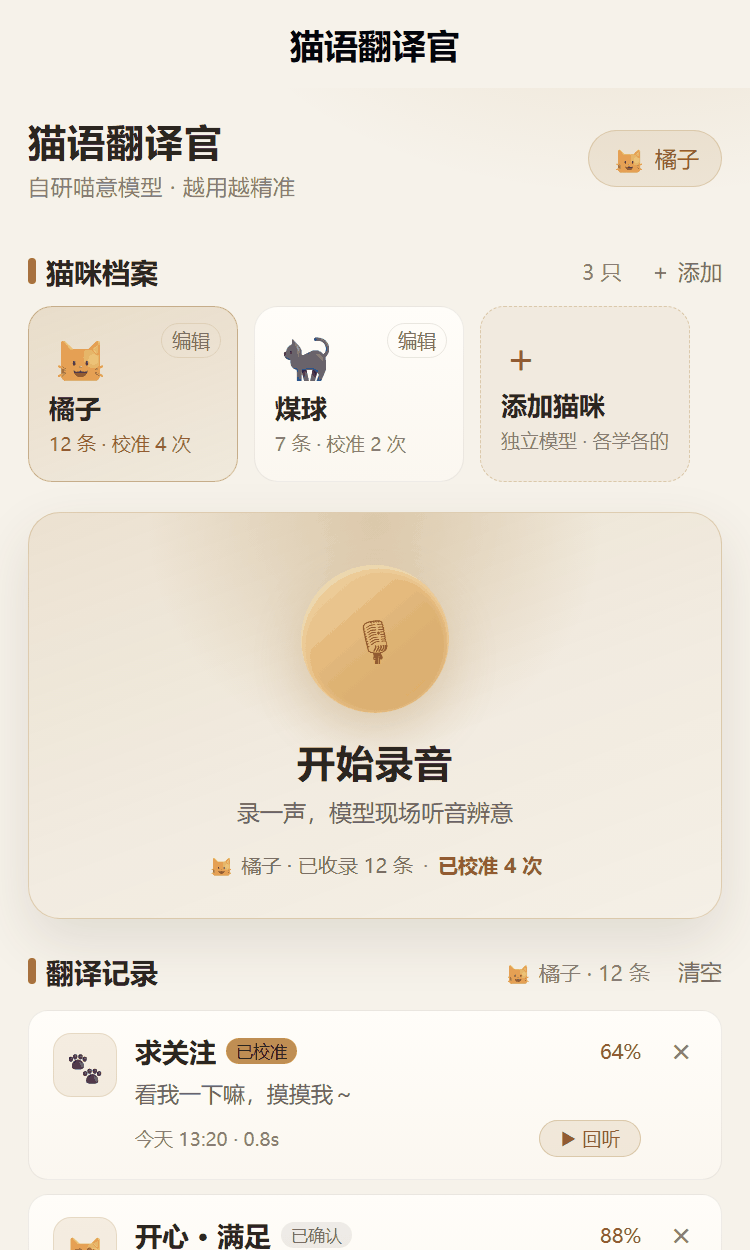
同一句叫声,在不同猫身上可能表达不同的事。所以一声喵给每只猫单独建档案,也单独校准。
判断不准的时候,点「校准」,选出正确的那一类就好。系统只记录改判,不记录顺手点掉的确认——这条规则很关键,否则偏好会被垃圾数据带偏。
每只猫保留最近 5 次校准。同一类别每被选中一次,它在后续打分中的权重提高 8%,最高累计 40%。也就是说,大约三五次之后,结果就会明显偏向你家这只猫的习惯。
删掉某只猫的档案时,它的校准偏好会一起清空,不会留在别处。
权重提升不等于必然翻盘。当原始声学得分差距很大时,校准也压不过去,这是有意为之——避免为了讨好用户而给出明显违背声音特征的结论。
没有账号体系,没有云端推理。声音从麦克风进,从屏幕出,中间不经过任何服务器。
没有账号体系,不需要手机号登录,也不采集通讯录、位置等信息。自己建的喵意类型同样只存在本机,存的是特征向量,不是音频。换手机不会同步,这是本地存储的代价,也是它不需要注册的原因。
关于准确度、隐私、费用和使用方式,这里都写清楚了。
扫一下码,或在微信里搜「一声喵」,就能直接打开。不用下载,不花一分钱,也不会把家里的声音传到任何地方。